
透過 Dense Retrieval 和 Sparse Retrieval 我們可以拿到各自的 Top K,假設 Dense 和 Sparse 各自取 Top 10,我們難道就直接把最多 20 個候選結果全部回傳嗎?該如何做 ReRanking 呢?今天的文章中會介紹 Weighted Ranker 和 RRF Ranker 兩種 Reranking 方法,並示範如何在 Milvus 中使用 Hybrid Search。
Dense 與 Sparse 各自有一個分數,直接給它們不同權重加起來做排序: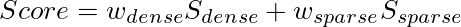
Dense 權重高一點就偏向語意一點,Sparse 權重高一點就偏向關鍵字一點。
但 Dense 算出來的分數跟 Sparse 算出來的分數,根本是不同的東西啊?舉例來說:
不同 metric 不能直接相加,所以相加前通常要先做 normalization,把原始 distance / score 轉成統一的 [0, 1] relevance score,以 Milvus 來說:
COSINE 原本就在 [-1, 1] 之間,直接映射就好:
normalized = (1 + score) / 2
IP 在 Milvus 中會用 arctan 方法: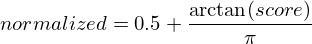
arctan 是反正切函數(inverse tangent),也就是 tan 的反函數,可以把從 -∞ 到 +∞ 的數值映射進 -π/2 到 π/2 之間: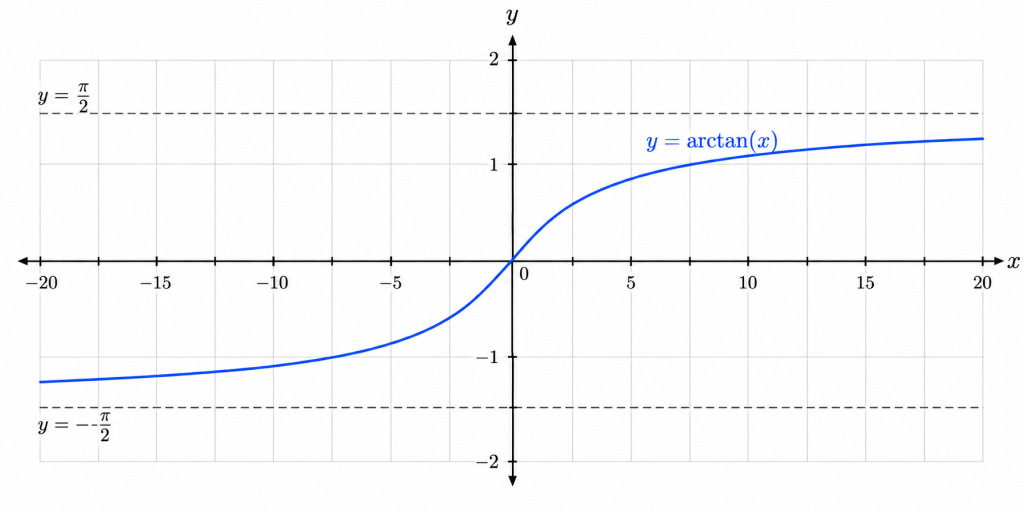
當然有很多其他函式可以做 normalize,只是 Milvus 選用 arctan。拿來跟標準的 sigmoid 做比較,能發現 arctan 尾端的收斂速度明顯比較慢,因此能在較大的 Score 區間保留更多差異。
套用回 IP 的 normalize 的公式,可以得到:
IP = -∞ → 接近 0
IP =  0 → 0.5
IP = +∞ → 接近 1
L2 也是用 arctan,只是有些調整: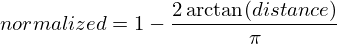
L2 = 0   → 1
L2 = +∞  → 接近 0
Milvus 並沒有明確列出 BM25 的 normalize 方法,不過猜測大概會是類似這樣: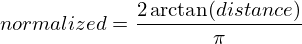
AnnSearchRequest 可以理解為一個還沒有真的執行 search() 的請求,而 hybrid_search() 吃的參數是 reqs: List[AnnSearchRequest],等於說我們是把請求和 ranker 傳進去,讓 Milvus 在背後幫我們處理實際的 searching 和 reranking。
from pymilvus import MilvusClient, AnnSearchRequest, Function, FunctionType

milvus_client = MilvusClient(uri="http://localhost:19530")

dense_search = AnnSearchRequest(
    data=[query_dense],
    anns_field="dense_vector",
    param={
        "metric_type": "COSINE",
        "params": {}
    },
    limit=20,
)

sparse_search = AnnSearchRequest(
    data=[query_sparse],
    anns_field="sparse_vector",
    param={
        "metric_type": "IP",
        "params": {}
    },
    limit=20,
)

weighted_ranker = Function(
    name="weighted_ranker",
    input_field_names=[],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "weighted",
        "weights": [0.7, 0.3],
        "norm_score": True,
    }
)

results = milvus_client.hybrid_search(
    collection_name="documents",
    reqs=[
        dense_search,
        sparse_search,
    ],
    ranker=weighted_ranker,
    limit=5,
    output_fields=["text"],
)
直接用分數來加權真的是好的嗎?就算做過 normalization,如果某一路的 weight 或 score 長期比較佔優勢,最後的結果會不會仍然偏向其中一路?RRF 是 Reciprocal Rank Fusion,完全不看 score 只看原本各自的排名,公式: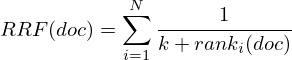
i 指的是第幾個 Retrieval,所以概念上是說:rank_i(doc) 代表文件在第 i 個搜尋結果中的排名,因此同一份文件如果在 Dense 和 Sparse Search 中都排得很前面,就會累積比較高的 RRF Score;反過來說,如果只在其中一路排名很前面,得到的加分就會比較有限。k 可以理解成「Ranking 差距有多重要」,假設 k 很小,那第 1 名和第 10 名的分數會差很多;反過來 k 越大,不同排名之間的差距就會被壓縮。Milvus 目前預設 k=60,並建議在 [10,100] 中調整。RRF 的好處是完全不需要在意 Dense、Sparse 原本使用什麼 Metric,也不用處理不同 Score 之間的尺度問題,只要知道各自的 Ranking 就能直接進行 Fusion。
把 ranker 改成 rrf。
rrf_ranker = Function(
    name="rrf_ranker",
    input_field_names=[],
    function_type=FunctionType.RERANK,
    params={
        "reranker": "rrf",
        "k": 60,
    }
)

results = milvus_client.hybrid_search(
    collection_name="documents",
    reqs=[
        dense_search,
        sparse_search,
    ],
    ranker=rrf_ranker,
    limit=5,
    output_fields=["text"],
)
中秋節快樂。


 iThome鐵人賽
 看影片追技術